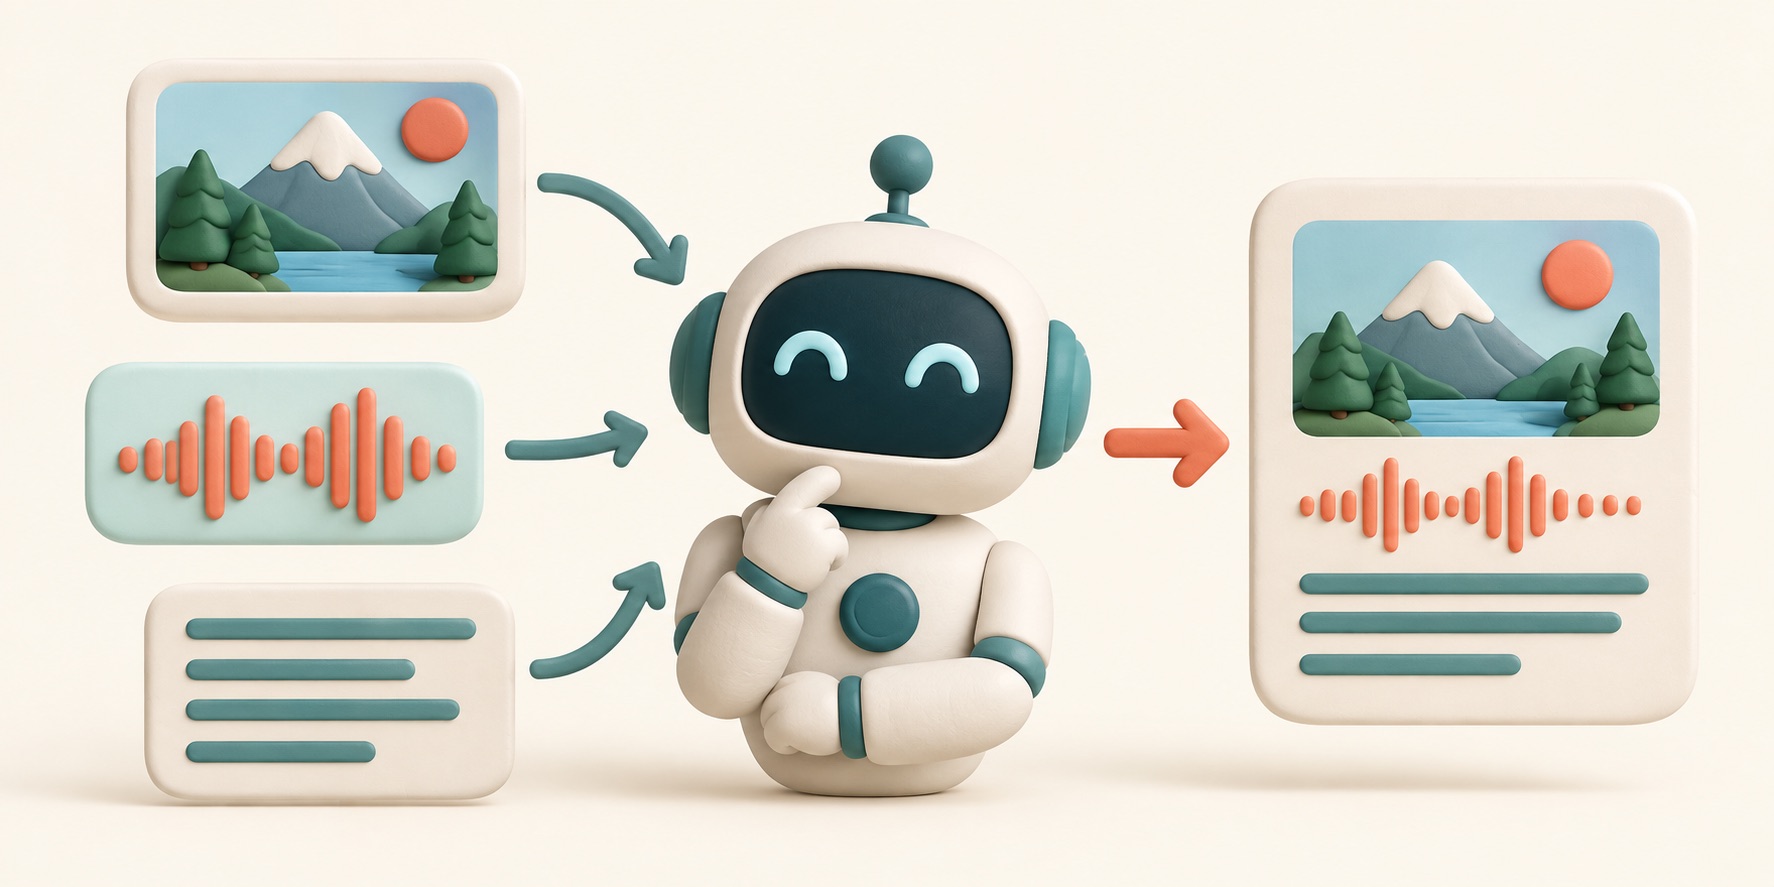
Multimodale KI kann mit mehr als einer Informationsart oder „Modalität“ arbeiten, etwa mit Text, Bildern und Audio. Ein herkömmliches reines Textwerkzeug nimmt vor allem Text auf und gibt Text aus. Ein multimodales Werkzeug kann auch ein Foto beschreiben oder auf gesprochene Worte reagieren.
Sie könnten einer KI zum Beispiel das Bild eines verwirrenden App-Bildschirms zeigen und fragen, was die Schaltflächen offenbar tun. Sie nutzt das Bild zusammen mit Ihrer Frage als Eingabe.
Die KI kann weiterhin missverstehen, was sie sieht oder hört. Prüfen Sie wichtige Details selbst, besonders wenn ein unscharfes Bild oder eine undeutliche Aufnahme die Antwort verändern könnte.